Que la IA no invente: lo que aprendí generando sitios para negocios reales
Precios, nombres y cifras que la IA nunca escribe, salidas validadas como datos y un respaldo que resultó peor que el problema: lecciones de poner un modelo a escribir sitios de verdad.
10 min de lectura
En RapiSites, la IA escribe el sitio entero de un negocio a partir de cuatro respuestas: cómo se llama, qué hace, cómo contactarlo y qué estilo le gusta. Eso funciona muy bien, pero un modelo puede escribir, con toda la confianza del mundo, «Más de 15 años de experiencia» sobre una barbería que abrió el año pasado.
Un texto genérico se corrige. Un dato falso publicado en el sitio de un negocio real es un problema para ese negocio. Estas son las reglas que salieron de eso, con las decisiones que tomé y las que tuve que corregir.
Primero, dónde puede inventar
La generación usa la API de Claude y corre en tres etapas: una llamada decide qué secciones del catálogo lleva cada una de las cuatro páginas; después se escribe el contenido con una llamada por sección, todas en paralelo; y al final una llamada por página escribe la meta descripción y el texto alternativo de las imágenes. Son entre 12 y 20 llamadas por sitio, y cada una es una oportunidad de que el modelo complete un hueco con algo que suena bien y no es cierto.
1. Hay cosas que la IA no escribe nunca
- Precios: alguien puede llegar al local con el precio equivocado en la mano.
- Nombres de personas, en reseñas y en el equipo: una reseña firmada por alguien que no existe es engañar al consumidor, y en muchos países es publicidad ilegal.
- Cifras verificables: años de trayectoria, cantidad de clientes, premios. Es lo que un modelo completa con más naturalidad y lo que más daño hace si es falso.
Cada sección del catálogo trae, campo por campo, una instrucción para la IA. En un precio, la instrucción dice que nunca invente uno y que escriba exactamente un marcador. Lo mismo en el autor de una reseña, en el nombre de cada integrante del equipo y en su presentación, que pide no inventar años de experiencia. En una lista de servicios, pide usar solo los que el negocio mencionó.
Lo que aprendí es que eso no se resuelve con el prompt. Pedirle al modelo «no inventes precios» funciona casi siempre, y «casi siempre» no alcanza. Así que el sistema no confía en el prompt: pone un marcador concreto en esos campos y lo vuelve comprobable.
| Dato | Marcador guardado | Cómo se ve en el sitio |
|---|---|---|
| Precio | «—» | Pastilla «A definir» |
| Cifra (años, clientes, cantidades) | «—» | Pastilla «A definir» |
| Autor de una reseña | «Nombre del cliente» | El texto tal cual, con la reseña marcada como ejemplo |
| Integrante del equipo | «Nombre» | El texto tal cual |
| Casilla del muro de logos | «Tu logo aquí» | El texto tal cual, nunca un logo falso |
Los marcadores viven en un solo archivo: la generación los usa tal cual y la auditoría los encuentra sin adivinar.
// Simplificado: los huecos que la IA no rellena, en un solo lugar.
export const PRICE = "—";
export const STAT = "—";
export const AUTHOR = "Nombre del cliente";
export const PLACEHOLDERS = [PRICE, STAT, AUTHOR /* , … */];

export const isPlaceholder = (text?: string) =>
  text !== undefined && PLACEHOLDERS.includes(text.trim());
Esa función de una línea la usan tres piezas:
- La auditoría previa a publicar: si encuentra un marcador, muestra un aviso amarillo («hay un dato pendiente en tal sección») con un botón que lleva directo a esa sección en el editor.
- Las reseñas: además del nombre marcador, cada reseña generada lleva
isExampleen verdadero, y mientras siga así la auditoría avisa que hay una reseña de ejemplo sin reemplazar. - Los datos estructurados: una reseña de ejemplo nunca sale como
Reviewen el JSON-LD. Son dos redes a la vez: si el dueño cambió el texto pero olvidó desmarcar el ejemplo, o al revés, el nombre marcador igual la frena.
Las fotos siguen la misma idea. No las escribe el modelo: un campo de imagen obligatorio busca una foto de stock del rubro en Pexels, con un término corto que devuelve la llamada de estructura («barbershop interior», por ejemplo). Pero el equipo, la galería y el logo están marcados para no usar stock nunca, porque una foto de banco ahí sería mostrar algo que no es del negocio. Si el campo es opcional se queda vacío; si es obligatorio, lleva un placeholder que se nota que hay que reemplazar.
2. El marcador también es diseño
Al principio el marcador de precio y de cifra era un guion: «—». En una lista de precios recién generada se veía así: el nombre del platillo, una línea de puntos y un guion suelto. En una sección de estadísticas, tres guiones donde iban los números.
En una revisión de la interfaz me di cuenta de que eso se leía como un error de render, no como un dato pendiente. Y como la auditoría solo avisa y no bloquea, un sitio publicado podía mostrarle esa fila de guiones a un visitante.
La decisión fue separar el dato de cómo se dibuja. El dato sigue siendo «—» para el modelo, la auditoría y los datos estructurados, así que nada de eso hubo que tocar. Lo que cambió es la sección: cuando el valor es el marcador, dibuja una pastilla tenue que dice «A definir». Su contraste es de 6,9:1, holgado para AA (el gris de antes no llegaba), y el aria-label que ya existía se quedó: un lector de pantalla oye «Precio por definir». Fueron ocho secciones, y un test comprueba que ninguna renderiza un guion suelto.
| Alternativa | Por qué la descarté |
|---|---|
| Un recuadro punteado del ancho de un precio, sin texto | Parece un wireframe y no dice qué falta. |
| Dejar el guion y documentarlo | La auditoría no bloquea: el visitante podía ver la fila de guiones igual. |
| Que la IA ponga un precio de ejemplo plausible | Es justo lo que la regla prohíbe. |
| Bloquear la publicación si queda un marcador | Aleja del sitio publicado en minutos por un dato que el dueño puede completar después. |
Lo que consideré antes de quedarme con la pastilla «A definir».
La última es la que más me costó descartar, porque bloquear se siente más seguro. Pero la regla que manda en RapiSites es que cualquiera pueda tener su web en minutos, y un negocio puede querer publicar hoy y poner los precios mañana. El aviso amarillo, que deja publicar pero no deja olvidarlo, es el punto medio. Mismo dato, otro mensaje: ya no parece roto, parece una tarea.
3. La salida del modelo es datos, no instrucciones
Cada sección se define con un esquema de Zod. Ese esquema se convierte a JSON Schema y se le pasa a Claude como la única herramienta disponible, con la elección forzada: el modelo no responde texto libre, responde llenando esa herramienta. Después se valida con Zod, y si no cumple se reintenta con el error de validación pegado al prompt, para que el modelo sepa exactamente qué corregir.
// Simplificado: pedir datos con forma, validarlos y reintentar con el error.
for (let attempt = 0; attempt <= maxRetries && !result; attempt++) {
  const res = await claude.messages.create({
    tools: [{ name: "respond", input_schema: toJsonSchema(schema) }],
    tool_choice: { type: "tool", name: "respond" },
    messages: [{ role: "user", content: prompt }],
  });
  const parsed = schema.safeParse(toolInput(res));
  if (parsed.success) result = parsed.data;
  else prompt = `${basePrompt}\n\nNo cumpliste el formato: ${parsed.error.message}`;
}- Las secciones de contenido tienen dos reintentos, no uno. Respetar un máximo de caracteres exacto es lo que más le cuesta al modelo, y un intento de más sale barato comparado con publicar un respaldo.
- No uso el modo estricto de la herramienta: solo acepta mínimos de 0 o 1 elementos en una lista, y el catálogo pide colecciones con mínimos reales (tres beneficios, dos integrantes). La validación fuerte la hace Zod igual.
- La estructura se valida con reglas que cruzan campos: el inicio empieza con exactamente un hero y ninguna otra página lleva uno, contacto tiene que tener una sección de contacto, no se repite ni se salta una página, no se elige nada fuera del catálogo, y el menú y el pie no los elige la IA.
- Nada de lo que devuelve el modelo se ejecuta. Y aquí tuve que corregir algo: el texto con formato que escribe una persona en el editor pasaba por un sanitizado con lista blanca de etiquetas, pero el camino de las plantillas y de la IA guardaba el contenido tal cual. Lo encontró una auditoría de seguridad. Ahora todo pasa por el mismo filtro, lo escriba quien lo escriba.
Lo que el esquema no atrapa
- Enlaces que no llevan a ningún lado. Un modelo puede escribir un botón «Reservar» que apunta a
#reservaro a/promociones. El prompt ahora le da la lista exacta de rutas del sitio, y una red de contención revisa cada enlace: deja pasar teléfono, correo y direcciones externas, y cambia cualquier ruta inexistente por la página de contacto. - Respuestas anidadas. La primera versión describía los campos como una lista de objetos con una propiedad
name, y el modelo terminaba metiendo todo bajo la única clave que reconocía: unbodycon el título, el texto y el botón adentro. Lo arreglé describiendo los campos con la misma forma que tiene que tener la respuesta, más un ejemplo literal por tipo de campo. - El tono. Mis prompts estaban escritos en voseo y nunca decían qué trato usar, así que el modelo copiaba el del prompt y escribía «contanos qué necesitás». Ahora la instrucción pide tuteo explícitamente, con contraejemplos, y un test comprueba que esa regla le llega al modelo.
4. El respaldo puede ser peor que el problema
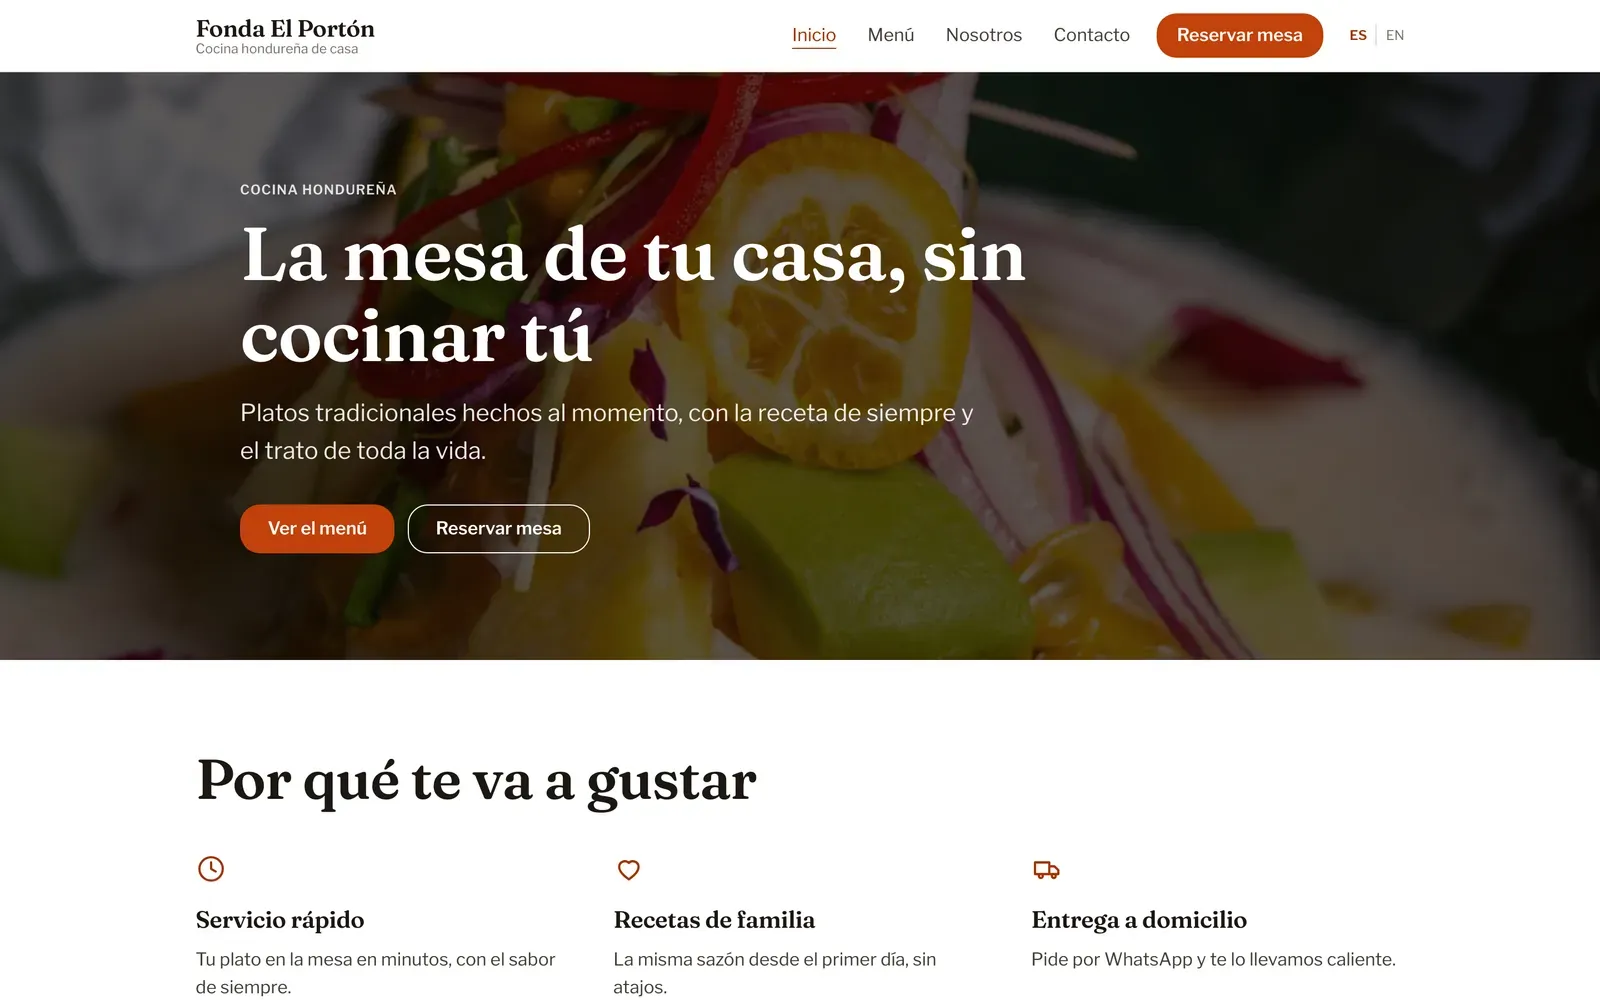
Si tras los reintentos una sección sigue sin validar, el cliente no ve un error: se usa un respaldo. El original eran los textos por defecto de cada sección del catálogo, escritos para el negocio de ejemplo del banco de pruebas: una barbería. Si la IA fallaba en una sección del sitio de un dentista, el dentista terminaba con un párrafo sobre cortes de pelo. Y eso llegó a aparecer en sitios generados de verdad.
| Paso | Qué se usa | Cuándo |
|---|---|---|
| 1 | El contenido de la IA | Si valida en el primer intento o en uno de los dos reintentos. |
| 2 | La misma sección en una plantilla de lanzamiento | Si alguna plantilla usa ese tipo y variante: texto neutral, sin rubro. |
| 3 | Los textos por defecto del catálogo | Solo si ninguna plantilla usa esa sección. |
La cadena de respaldo después de la corrección. Un test comprueba que el paso 2 gana sobre el ejemplo de barbería.
El SEO tiene su versión: si la meta descripción de una página no valida, se usa la descripción del negocio recortada a 160 caracteres. Una página que falla no arrastra a las demás.
Ese mismo día apareció otro problema de la misma familia. Como el menú y el pie no los planea la IA, el sitio armado a partir de su plan no los tenía: todos los sitios generados perdían en silencio la navegación y el pie. La plantilla elegida los traía, pero nadie los volvía a poner. Lo que el modelo no produce por diseño, alguien tiene que ponerlo, y hay que comprobarlo con un test.
5. Medir cuánto cuesta, aunque falle
La IA es el único costo variable por cliente del sistema. Por eso cada llamada guarda una fila con el tipo (estructura, contenido, SEO o traducción), el modelo, los tokens de entrada y de salida, el costo en dólares, la duración y si falló. Se registra siempre, incluso cuando la respuesta nunca validó, porque la llamada ya se pagó.
// Simplificado: el registro va después del bucle, pase lo que pase.
await aiGenerations.create({
  kind, model, inputTokens, outputTokens,
  costUsd: (inputTokens * rate.input + outputTokens * rate.output) / 1_000_000,
  durationMs: Date.now() - startedAt,
  failed: result === undefined,
});
if (result === undefined) throw new AiValidationError(lastIssues);
Con eso, las métricas del producto muestran el costo de IA por sitio generado en los últimos 30 días y la tasa de llamadas fallidas. Sin ese registro no hay forma de fijar precios con criterio. El costo también se acota del lado del producto: el cupo de sitios con IA es el mismo que el de sitios del plan (1, 3 o 10), hay un límite de cinco generaciones cada quince minutos, y una sola generación a la vez por cuenta. Ese candado lo pidió una auditoría de seguridad: sin él, varias peticiones simultáneas pasaban el chequeo de cupo antes de que terminara la primera.
Si vas a poner un modelo a escribir para clientes reales
- Haz una lista explícita de lo que el modelo no puede inventar en tu dominio, y para cada cosa define un marcador, no solo una instrucción.
- Haz que ese marcador lo encuentre el código: una auditoría, un test, un filtro antes de los datos estructurados.
- Piensa cómo se ve el marcador. Un hueco que parece un error genera desconfianza; uno que parece una tarea genera acción.
- Fuerza la salida a un esquema, valídala y reintenta con el error a la vista. Y pon redes para lo que el esquema no ve: enlaces, tono, forma.
- Revisa tu respaldo como si fuera el camino principal, porque para alguien lo va a ser. Y registra el costo de cada llamada desde el primer día, también de las que fallan.
Lo que me llevo: con IA en producción, la pregunta no es si el modelo es bueno, sino qué pasa el día que se equivoca. Ese día lo diseñas tú, con marcadores que el código pueda encontrar y un respaldo que no empeore las cosas.
¿Te sirvió? Hablemos de tu proyecto.
Si estás construyendo algo parecido y querés una mano con el diseño o el frontend, escribime.
Hablemos